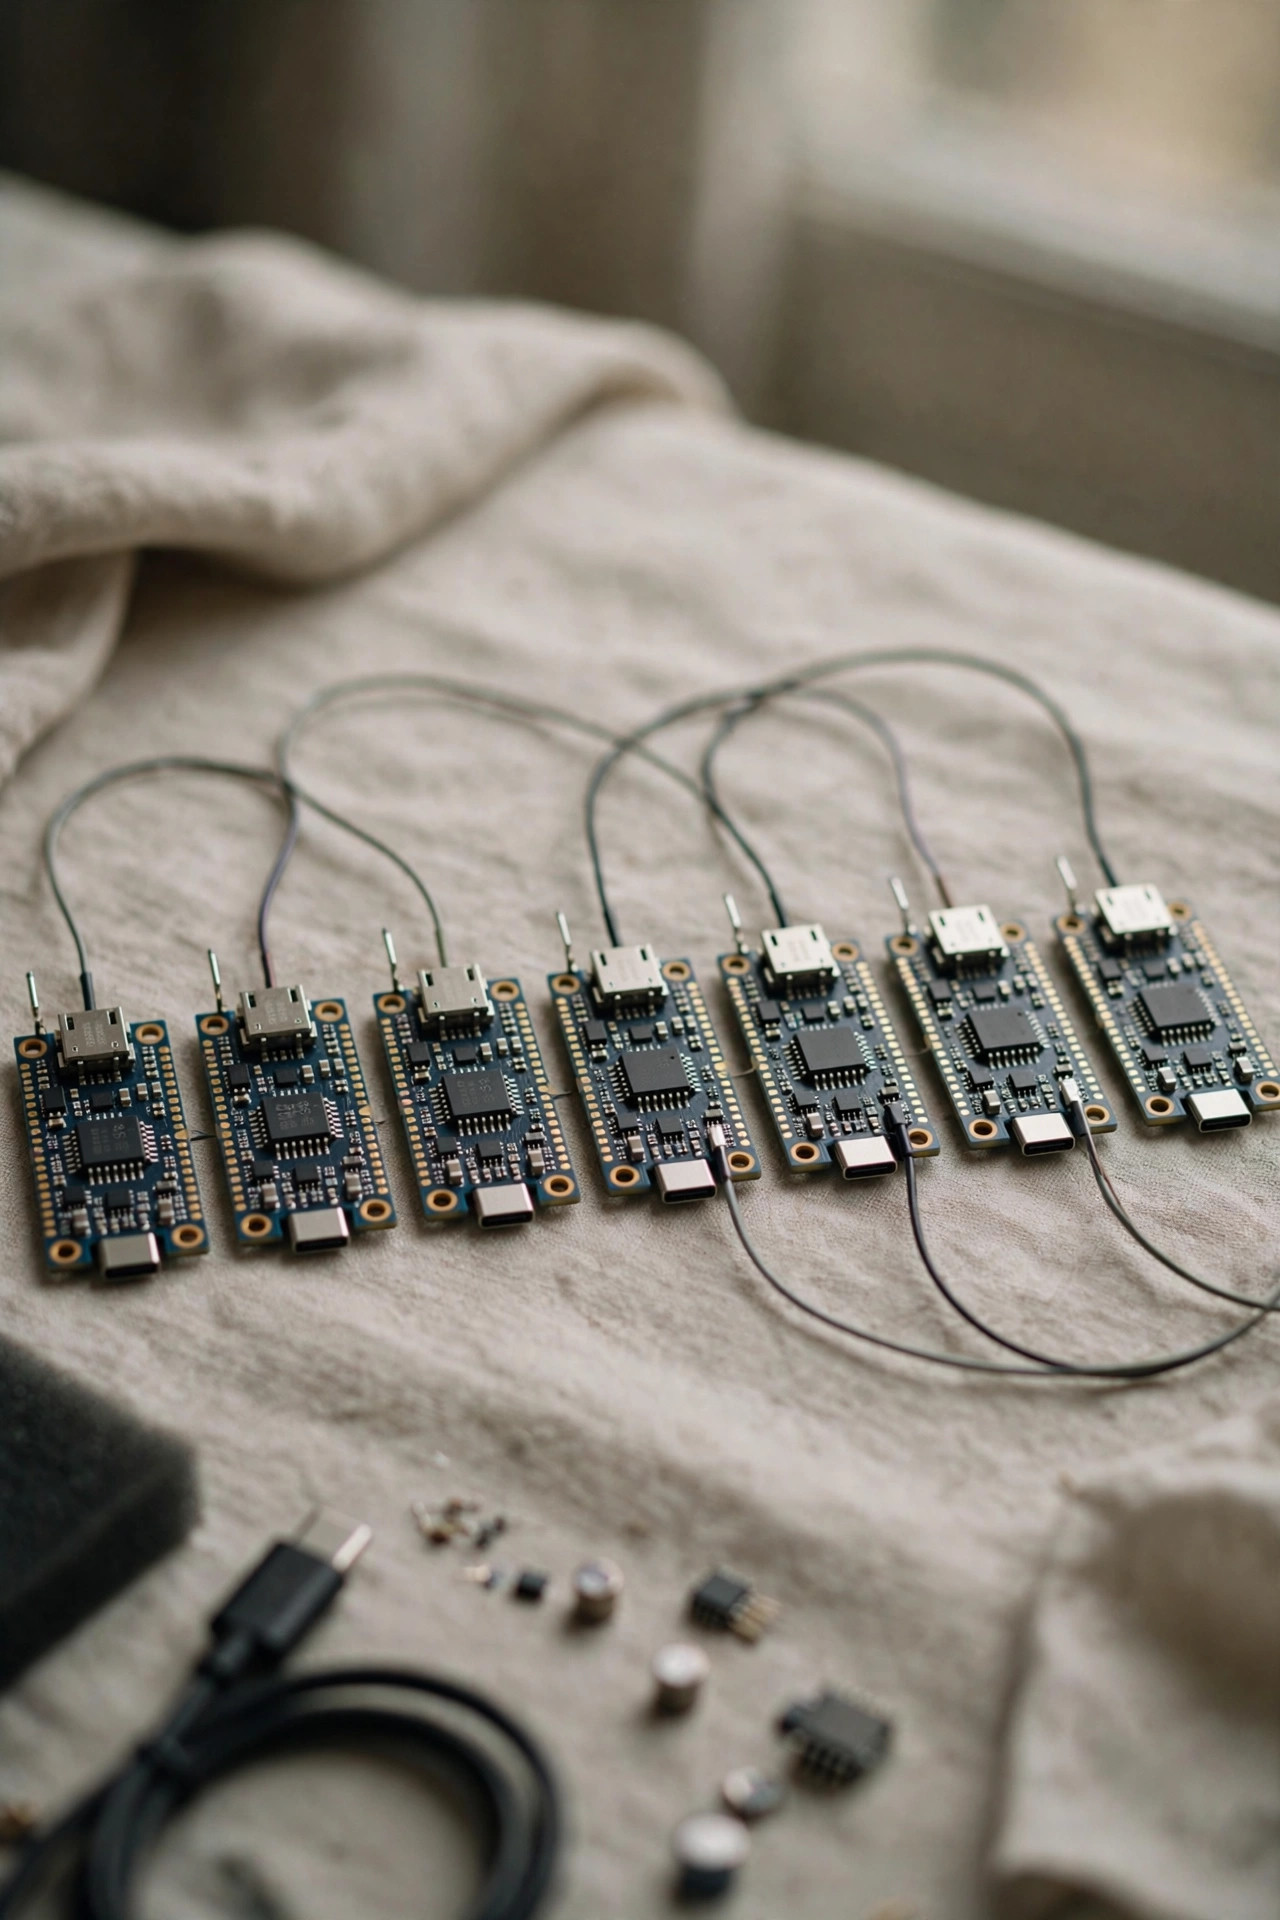
1.58位量化把0.4B模型塞进单片机集群
GitHub上本周走红的ESP32s3-LLM-Cluster项目给出一个硬核答案:谁说大模型推理一定要GPU。作者用7片ESP32-S3单片机组成了一个分布式推理集群,跑起一个0.4B参数的语言模型,量化方式是BitNet的1.58位三值方案。仓库创建于2026年8月6日,最近一次推送在9月26日,主要语言为C++,采用MIT许可证,目前已收获88颗星与5个派生。
架构上,7片芯片分成一个主控与六个计算节点:主控负责BPE分词与token嵌入,嵌入表以INT4精度存放,占用约14MB Flash空间;注意力层与MLP则被拆给六个节点,每个节点各扛4个Transformer块(节点1负责第0至3层,节点6负责第20至23层)。主控与节点之间通过高速SPI菊花链传递FP32格式的隐状态向量——主控从SPI通道A发给节点1,节点逐级接力,最后一个节点再把结果送回主控做最终归一化与采样。
每个节点都是完整的1.58位Transformer运行时
计算节点上的实现并不含糊:RMSNorm以FP16标定后转FP32运算,注意力的Q、K、V、O投影与MLP的Gate、Up、Down投影全部跑1.58位三值化,位置编码用RoPE,KV缓存放在PSRAM里。为了把三值矩阵乘法压榨到极限,作者手写了汇编优化的MAC运算,并配合查找表做极限优化;最终归一化占64KB,放在单独的fnorm分区,LM Head与INT4嵌入表共享权重,采样用贪心解码。节点固件里还能直接看到Qwen注意力、RoPE与KV缓存的运行时代码。
模型本身不是拿来就跑,作者用一套Python工具链做了完整的预处理:词表裁剪到3.2万token、嵌入矩阵切片、BitNet量化感知微调、INT4嵌入打包、分词器序列化为ESP32二进制,以及把1.58位层块按物理对齐打包进固件。项目致谢名单里,1.58位三值量化的概念来自微软BitNet项目,多节点分布式单片机AI的灵感则来自另外两个ESP32-S3开源项目。仓库还提供多线程批量烧录脚本,7片板子可以一并刷写。
Hacker News上52点赞的帖子里,评论不多但态度分化明显。有人直言这种压缩程度让集群更像一个花哨的LLM噪声发生器,但承认它足够有趣;也有人正在做同类项目,参数量压到1.5亿、量化更轻,认为这条路线在边缘设备上有实际价值;还有读者在认真讨论它能不能做语法检查,或为文字冒险游戏生成世界——对单片机集群的能力边界,多数人心里并没有数。
把BitNet的1.58位方案搬到ESP32-S3上,意义不在于算力替代,而在于把推理的物理门槛压到几美元一片的微控制器上。它展示了一种与云端API完全相反的路径:模型可以被切开、极度量化,然后由一群低功耗芯片用SPI协作吐出token。对离线设备、隐私敏感场景或者单纯想在自己桌面上跑通一个完整推理流水线的爱好者来说,这种不联网也能推理的可行性证明本身就有价值。